
সকল বোর্ড ২০২৬

এইচএসসি · পরিসংখ্যান ১ম পত্র

সকল বোর্ড ২০২৬

৮টি প্রশ্ন রয়েছে। নিচে কয়েকটি নমুনা দেখো; সব প্রশ্ন, উত্তর ও ব্যাখ্যা পেতে সাবস্ক্রাইব করো।

একটি কলেজের দ্বাদশ শ্রেণির $5$ জন ছাত্রের পরিসংখ্যান $১$ম ও $২$য় পত্রের $10$ নম্বরের শ্রেণি পরীক্ষার প্রাপ্ত নম্বর নিম্নরূপ :

নিম্নলিখিত তথ্য হতে নিম্নলিখিত প্রশ্নগুলোর উত্তর দাও:

পরিসংখ্যান ১ম পত্র (x) পরিসংখ্যান ২য় পত্র (y)
6 4
7 5
8 6
9 7
5 3

অনিক বলল যে, $\sum_{i=1}^{5} x_i^2 > \sum_{i=1}^{5} y_i^2$

১. চলক কাকে বলে?
কোনো বইয়ে প্রতি পৃষ্ঠায় ভুলের সংখ্যা কোন ধরনের চলক? ব্যাখ্যা কর।
$\sum_{i=1}^{5} (2x_i + 3)$ এর মান নির্ণয় কর।
উদ্দীপকের আলোকে অনিকের বক্তব্য যাচাই কর।
সমাধান ও উত্তর
(ক)
অনুসন্ধানাধীন কোনো সমগ্রক বা নমুনার যেসব বৈশিষ্ট্য উপাদানভেদে পরিবর্তিত হয় এবং যা সংখ্যায় পরিমাপ করা যায়, তাকে চলক বলে। যেমন: শিক্ষার্থীদের বয়স, উচ্চতা, ওজন ইত্যাদি।
(খ)

কোনো বইয়ে প্রতি পৃষ্ঠায় ভুলের সংখ্যা হলো বিচ্ছিন্ন চলক।

যে চলক কেবল নির্দিষ্ট ও পৃথক মান (সাধারণত পূর্ণসংখ্যা) গ্রহণ করতে পারে এবং যার মান গণনা করে নির্ণয় করা হয়, তাকে বিচ্ছিন্ন চলক বলে। কোনো বইয়ের পৃষ্ঠায় ভুলের সংখ্যা গণনাযোগ্য এবং তা সবসময় পূর্ণসংখ্যায় হয় (যেমন- $০, ১, ২, ৩$ ইত্যাদি)। ভুলের সংখ্যা কখনো ভগ্নাংশ (যেমন $\mathrm{-১.৫}$ বা $২.৩$) হতে পারে না। যেহেতু এর মান কেবল পৃথক বা পূর্ণসংখ্যা হতে পারে, তাই এটি একটি বিচ্ছিন্ন চলক।

(গ)

দেওয়া আছে,

পরিসংখ্যান ১ম পত্রের চলক,

$x_i=6,7,8,9,5$

এখানে, $x_1=6, x_2=7, x_3=8, x_4=9$

এবং $x_5=5$

এখন, $\sum_{i=1}^5\left(2 x_i+3\right)$

$=\left(2 x_1+3\right)+\left(2 x_2+3\right)+\left(2 x_3+3\right)+\left(2 x_4+3\right)+\left(2 x_5+3\right)$

$=(2 \times 6+3)+(2 \times 7+3)+(2 \times 8+3)+(2 \times 9+3)+(2 \times 5+3)$

$=(12+3)+(14+3)+(16+3)+(18+3)+(10+3)$

$=15+17+19+21+13$

$=85$

সুতরাং, $\sum_{i=1}^5\left(2 x_i+3\right)=85 \text {. }$

(ঘ)

দেওয়া আছে,

পরিসংখ্যান ১ম পত্রের চলক,

$x_i=6,7,8,9,5$

এখানে, $x_1=6, x_2=7, x_3=8, x_4=9$

এবং $x_5=5$

এখন $\sum_{i=1}^5 x_i^2$

$=x_1^2+x_2^2+x_3^2+x_4^2+x_5^2$

$=6^2+7^2+8^2+9^2+5^2$

$=36+49+64+81+25$

$=255$

সুতরাং, $\sum_{i=1}^5 x_i^2=255$.

আবার, দেওয়া আছে,

পরিসংখ্যান ২য় পত্রের চলক,

$y_i=4,5,6,7,3$

এখানে, $y_1=4, y_2=5, y_3=6, y_4=7$

এবং $y_5=3$

এখন, $\sum_{i=1}^5 y_i^2$

$ =y_1^2+y_2^2+y_3^2+y_4^2+y_5^2$

$=4^2+5^2+6^2+7^2+3^2$

$ =16+25+36+49+9$

$=135$

সুতরাং, $\sum_{i=1}^5 y_i^2=135$.

যেহেতু, $255 > 135$

তাই, $\sum_{i=1}^5 x_i^2>\sum_{i=1}^5 y_i^2$

অর্থাৎ, উদ্দীপকে উল্লিখিত অনিকের বক্তব্যটি সঠিক।
20 জন শিক্ষার্থীর কোনো পরীক্ষায় প্রাপ্ত নম্বর নিম্নে দেওয়া হলো:

85, 77, 72, 34, 58;

52, 42, 48, 66, 54;

41, 45, 56, 60, 64;

78, 57, 43, 74, 47।

২. গণসংখ্যা কাকে বলে?
প্রাথমিক তথ্য কি অধিক নির্ভরযোগ্য? ব্যাখ্যা কর।
উপযুক্ত শ্রেণি ব্যবধান নিয়ে গণসংখ্যা নিবেশন তৈরি কর।
উদ্দীপকের আলোকে কোন নম্বর শ্রেণির শিক্ষার্থীর সংখ্যা সর্বোচ্চ—উপযুক্ত লেখ অঙ্কনপূর্বক মন্তব্য কর।
সমাধান ও উত্তর
(ক)
কোনো তথ্যসারিতে বা নিবেশনে একটি নির্দিষ্ট মান বা ঘটনা যতবার ঘটে বা উপস্থিত থাকে, সেই নির্দিষ্ট সংখ্যাটিকে ঐ মান বা শ্রেণির গণসংখ্যা বলে।
(খ)
সঠিক নকশা, প্রশিক্ষিত সংগ্রাহক ও মাননিয়ন্ত্রণ থাকলে সরাসরি মূল উৎস থেকে বর্তমান উদ্দেশ্যে সংগৃহীত প্রাথমিক তথ্য অধিক প্রাসঙ্গিক ও নির্ভরযোগ্য হতে পারে। তবে প্রাথমিক তথ্য সবসময় নির্ভুল নয়—নমুনায়ন, পরিমাপ ও সংগ্রাহকের পক্ষপাত থাকতে পারে। মানসম্পন্ন মাধ্যমিক তথ্যও নির্ভরযোগ্য হতে পারে; তাই উৎস, পদ্ধতি ও ত্রুটি যাচাই করতে হয়।
(গ)

প্রদত্ত20টি নম্বর:

85, 77, 72, 34, 58;

52, 42, 48, 66, 54;

41, 45, 56, 60, 64;

78, 57, 43, 74, 47।

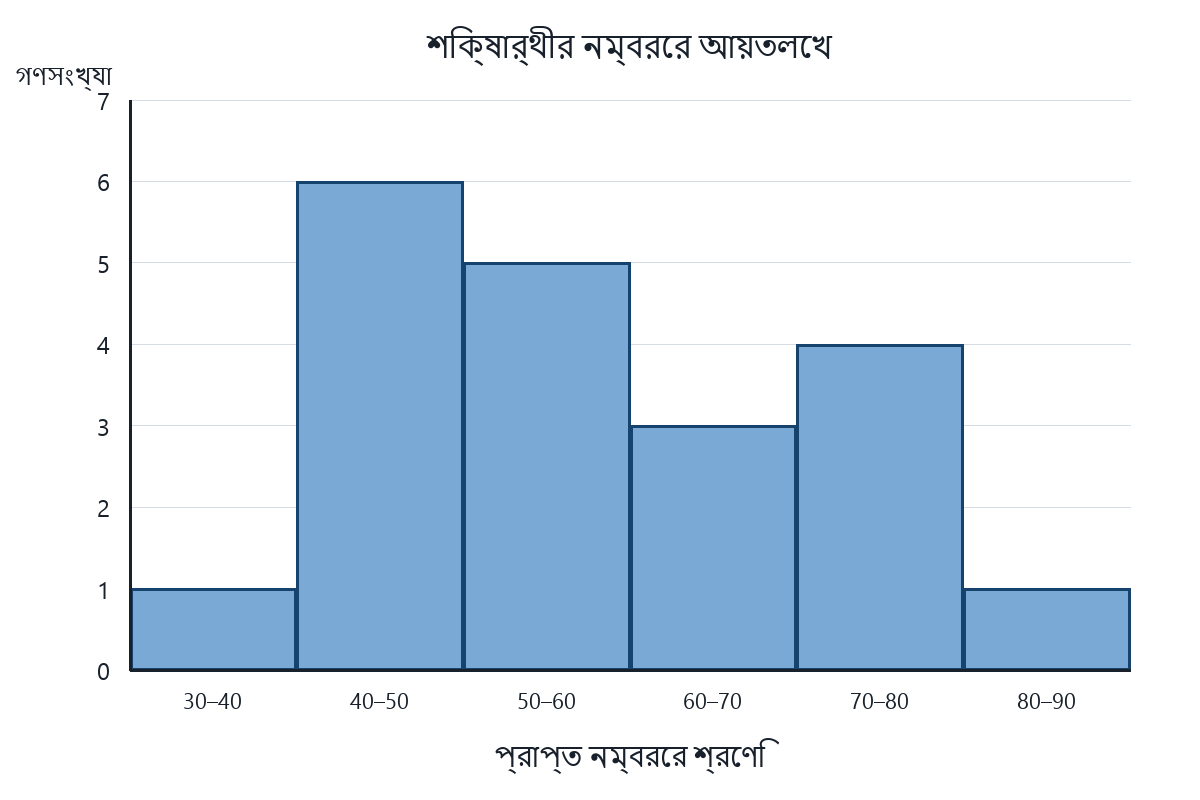
সর্বনিম্ন34, সর্বোচ্চ85; তাই পরিসর $R=85-34=51$। শ্রেণিব্যাপ্তি10 নিলে $51/10=5.1$; সব মান অন্তর্ভুক্ত করতে6টি শ্রেণি নেওয়া হলো।

শ্রেণিব্যাপ্তি ট্যালির সংখ্যা গণসংখ্যা f
30–40 1 1
40–50 6 6
50–60 5 5
60–70 3 3
70–80 4 4
80–90 1 1
মোট 20
(ঘ)

কোন শ্রেণির শিক্ষার্থীর সংখ্যা সর্বোচ্চ, তা প্রদর্শনের জন্য সবচেয়ে উপযুক্ত লেখচিত্র হলো আয়তলেখ $\text{(Histogram)}$। (গ) হতে প্রাপ্ত গণসংখ্যা নিবেশন সারণির সাহায্যে নিচে আয়তলেখ অঙ্কন করা হলো:

লেখচিত্র অঙ্কনের বিবরণ:ছক কাগজের $\text{(Graph paper)}$ $X-$অক্ষ বরাবর শ্রেণিব্যাপ্তি (নম্বর) এবং $Y-$অক্ষ বরাবর শিক্ষার্থীর সংখ্যা (গণসংখ্যা) স্থাপন করি। $X-$অক্ষের প্রতি $১$ ক্ষুদ্র বর্গঘর $= ১$ একক এবং $Y-$অক্ষের প্রতি $১$ ক্ষুদ্র বর্গঘর = $১$ একক ধরা হলো। মূলবিন্দু ($0$) থেকে $30$ পর্যন্ত ঘরগুলো ফাঁকা বোঝাতে ভাঙা চিহ্ন $\text{(Z-mark)}$ ব্যবহার করা হয়েছে।আয়তলেখ (নমুনা চিত্র):

উত্তরের ছবি

সাধনপুর গ্রামের লোকদের আয়ের বিন্যাস নিম্নরূপ :

আয় (টাকায়) লোকসংখ্যা
100–200 8
200–300 12
300–400 20
400–500 14
500–600 6

মিনা বলল যে, $\text{AM > HMI}$

৩. চতুর্থক কাকে বলে?
$20, 5, 15, 10$ তথ্য সারির কি প্রচুরক নির্ণয় করা সম্ভব? ব্যাখ্যা কর।
উদ্দীপকের তথ্য হতে মধ্যমা নির্ণয় কর।
উদ্দীপকের আলোকে মিনার বক্তব্যটি যাচাই কর।
সমাধান ও উত্তর
(ক)
কোনো নিবেশন বা তথ্যসারিকে মানের ক্রমানুসারে সাজালে যে তিনটি মান উক্ত তথ্যসারিকে সমান চারটি অংশে বিভক্ত করে, তাদের প্রত্যেকটিকে চতুর্থক বলে।
(খ)

না, প্রদত্ত তথ্যসারিটির ($20, 5, 15, 10$) প্রচুরক নির্ণয় করা সম্ভব নয়। অর্থাৎ, এই তথ্যসারির কোনো প্রচুরক নেই।

কোনো তথ্যসারিতে যে মানটি বা মানগুলো সর্বাধিকবার উপস্থিত থাকে, তাকে প্রচুরক বলে। প্রদত্ত তথ্যসারিতে বিদ্যমান মানগুলো হলো $5, 10, 15, 20$। এখানে প্রতিটি মানই কেবল একবার করে আছে। যেহেতু উপাত্তে কোনো সংখ্যাই সর্বাধিকবার বা একাধিকবার উপস্থিত নেই, তাই পরিসংখ্যানের সংজ্ঞানুসারে এই তথ্যসারির কোনো প্রচুরক নেই।

(গ)

মধ্যমা নির্ণয়ের জন্য প্রয়োজনীয় যোজিত গণসংখ্যা সারণি নিচে দেওয়া হলো :

আয় (টাকায়) জনসংখ্যা বা গণসংখ্যা (f) যোজিত গণসংখ্যা (Fc)
100–200 8 8
200–300 12 20
300–400 20 40
400–500 14 54
500–600 6 60
মোট 60

এখানে, মোট গণসংখ্যা $N = 60$
সুতরাং, মধ্যমা হবে $\frac{N}{2} = \frac{60}{2} = 30$ তম পদের মান।
যোজিত গণসংখ্যা সারণি থেকে দেখা যায়, $30$ তম পদটি $300-400$ শ্রেণির অন্তর্ভুক্ত।
অতএব, মধ্যমা শ্রেণি হলো $300-400$।

মধ্যমা নির্ণয়ের সূত্র হতে পাই: $Me = L + \frac{\frac{N}{2} - F_c}{f_m} \times c$

এখানে,
$L = 300$ (মধ্যমা শ্রেণির নিম্নসীমা)
$\frac{N}{2} = 30$
$F_c = 20$ (মধ্যমা শ্রেণির পূর্ববর্তী শ্রেণির যোজিত গণসংখ্যা)
$f_m = 20$ (মধ্যমা শ্রেণির গণসংখ্যা)
$c = 100$ (শ্রেণি ব্যবধান)

$Me = 300 + \frac{30 - 20}{20} \times 100$

$Me = 300 + \frac{10}{20} \times 100$

$Me = 300 + 50 = 350$
মধ্যমা: $350$

(ঘ)

গাণিতিক গড় ($AM$) ও তরঙ্গ গড় ($HM$) নির্ণয়ের সারণি:

আয় 100–200
মধ্যবিন্দু (x) 150
গণসংখ্যা (f) 8
fx 1200
f/x 0.0533
আয় 200–300
মধ্যবিন্দু (x) 250
গণসংখ্যা (f) 12
fx 3000
f/x 0.0480
আয় 300–400
মধ্যবিন্দু (x) 350
গণসংখ্যা (f) 20
fx 7000
f/x 0.0571
আয় 400–500
মধ্যবিন্দু (x) 450
গণসংখ্যা (f) 14
fx 6300
f/x 0.0311
আয় 500–600
মধ্যবিন্দু (x) 550
গণসংখ্যা (f) 6
fx 3300
f/x 0.0109
আয় মোট
মধ্যবিন্দু (x)
গণসংখ্যা (f) 60
fx 20800
f/x 0.2004

সারণি হতে পাই,

গাণিতিক গড়, $AM = \frac{\sum fx}{N} = \frac{20800}{60} = 346.67$

তরঙ্গ গড়, $HM = \frac{N}{\sum (f/x)} = \frac{60}{0.2004} = 299.40$

যেহেতু $346.67 > 299.40$, অর্থাৎ $AM > HM$। সুতরাং, উদ্দীপকে উল্লিখিত মিনার বক্তব্যটি সঠিক।

$A$ ও $B$ দুটি কারখানার শ্রমিকদের তথ্য নিম্নরূপ :

কারখানা A
শ্রমিক সংখ্যা 80
গড় মজুরি 500
পরিমিত ব্যবধান 50
কারখানা B
শ্রমিক সংখ্যা 60
গড় মজুরি 550
পরিমিত ব্যবধান 40
৪. বিস্তার কাকে বলে?
ভেদাংক ঋণাত্মক হতে পারে কি? ব্যাখ্যা কর।
উদ্দীপকের তথ্য হতে সম্মিলিত ভেদাংক নির্ণয় কর।
উদ্দীপকের আলোকে কোন কারখানার শ্রমিকের মজুরি অধিক সঙ্গতিপূর্ণ? বিশ্লেষণপূর্বক মন্তব্য কর।
সমাধান ও উত্তর
(ক)
কোনো নিবেশন বা তথ্যসারির মানগুলো তাদের কেন্দ্রীয় মান থেকে চারদিকে কতটুকু বিস্তৃত বা ছড়িয়ে আছে, তার পরিমাপকে বিস্তার বলে।
(খ)

না, ভেদাংক কখনো ঋণাত্মক হতে পারে না।

কোনো তথ্যসারির মানগুলো হতে তাদের গাণিতিক গড়ের ব্যবধানের বর্গের সমষ্টিকে মোট পদসংখ্যা দ্বারা ভাগ করলে যে মান পাওয়া যায়, তাকে ভেদাংক বলে। গাণিতিকভাবে, ভেদাংক হলো ব্যবধানের বর্গের গড়।

যেহেতু যেকোনো বাস্তব সংখ্যার বর্গ সবসময় ধনাত্মক বা শূন্য হয় তাই গাণিতিক গড় থেকে উপাত্তের মানগুলোর ব্যবধানের বর্গের সমষ্টিও কখনো ঋণাত্মক হতে পারে না। এই কারণে ভেদাংকের মান সবসময় অঋণাত্মক (ধনাত্মক বা শূন্য) হয়। যদি তথ্যসারির সবগুলো মান একই হয়, তবে ভেদাংক শূন্য হবে, কিন্তু কোনো অবস্থাতেই এটি ঋণাত্মক হবে না।

(গ)

উদ্দীপক হতে পাই,

কারখানা A এর ক্ষেত্রে:

শ্রমিক সংখ্যা, $n_1=80$

গড় মজুরি, $\bar{x}_1=500$

পরিমিত ব্যবধান, $\sigma_1=50$

$\therefore$ ভেদাংক, $\sigma_1^2=(50)^2=2500$

কারখানা B এর ক্ষেত্রে:

শ্রমিক সংখ্যা, $n_2=60$

গড় মজুরি, $\bar{x}_2=550$

পরিমিত ব্যবধান, $\sigma_2=40$

$\therefore$ ভেদাংক, $\sigma_2^2=(40)^2=1600$

আমরা জানি, সম্মিলিত গড়,

$\bar{x}_c = \frac{n_1\bar{x}_1 + n_2\bar{x}_2}{n_1 + n_2}$

$\bar{x}_c = \frac{80 \times 500 + 60 \times 550}{80 + 60}$

$\bar{x}_c = \frac{40000 + 33000}{140}$

$\bar{x}_c = \frac{73000}{140} = 521.43 \text{ (প্রায়)}$

সম্মিলিত ভেদাংক,

$\sigma_c^2 = \frac{n_1(\sigma_1^2 + d_1^2) + n_2(\sigma_2^2 + d_2^2)}{n_1 + n_2}$

$\sigma_c^2 = \frac{80 \{2500 + (-21.43)^2\} + 60 \{1600 + (28.57)^2\}}{140}$

$\sigma_c^2 = \frac{80(2500 + 459.24) + 60(1600 + 816.24)}{140}$

$\sigma_c^2 = \frac{80(2959.24) + 60(2416.24)}{140}$
$\sigma_c^2 = \frac{236739.2 + 144974.4}{140}$

$\sigma_c^2 = \frac{381713.6}{140}$

$\sigma_c^2 = 2726.53 \text{ (প্রায়)}$

সম্মিলিত ভেদাংক $2726.53$।

(ঘ)

উভয় কারখানার শ্রমিকের মজুরির সঙ্গতিপূর্ণতা যাচাই করার জন্য বিভেদাংক (CV) নির্ণয় করতে হবে। আমরা জানি, যে উপাত্তের বিভেদাংক অপেক্ষাকৃত কম, সেই উপাত্ত অধিক স্থিতিশীল বা সঙ্গতিপূর্ণ।

উদ্দীপক হতে পাই,

কারখানা A এর ক্ষেত্রে:

গড় মজুরি, $\bar{x}_1=500$

পরিমিত ব্যবধান, $\sigma_1=50$

$\therefore$ কারখানা A এর বিভেদাংক,

$CV(A) = \frac{\sigma_1}{\bar{x}_1} \times 100$

$CV(A) = \frac{50}{500} \times 100$

$CV(A) = 10\%$

কারখানা B এর ক্ষেত্রে:

গড় মজুরি, $\bar{x}_2=550$

পরিমিত ব্যবধান, $\sigma_2=40$

$\therefore$ কারখানা B এর বিভেদাংক,

$CV(B) = \frac{\sigma_2}{\bar{x}_2} \times 100$

$CV(B) = \frac{40}{550} \times 100$

$CV(B) = 7.27\% \text{ (প্রায়)}$

প্রাপ্ত ফলাফল হতে দেখা যায়, $CV(B) < CV(A)$, অর্থাৎ কারখানা $B$ এর মজুরির বিভেদাংক $\mathrm{(7.27\%)}$ কারখানা A এর মজুরির বিভেদাংকের $(10%)$ চেয়ে কম। যেহেতু কারখানা $B$ এর বিভেদাংক কম, তাই নির্দ্বিধায় বলা যায় কারখানা $B$ এর শ্রমিকের মজুরি অধিক সঙ্গতিপূর্ণ।

সকল বোর্ড ২০২৬ আনলক করো

এই টেস্ট পেপারটি প্রিমিয়াম প্যাকেজের অন্তর্ভুক্ত। সব বহুনির্বাচনি ও লিখিত প্রশ্ন অনুশীলন করতে সাবস্ক্রাইব করো।